
Рынок технологий искусственного интеллекта демонстрирует беспрецедентные темпы роста — крупнейшие технологические компании инвестируют значительные ресурсы в разработку и внедрение ИИ-решений, а руководители рассматривают искусственный интеллект в качестве обязательного элемента цифровой трансформации организаций. Однако, наряду с высокими ожиданиями, наблюдается существенный разрыв между инвестициями и фактической результативностью проектов. Многие организации сталкиваются с тем, что успешно продемонстрированные решения так и не переходят в промышленную эксплуатацию, а внедренные системы не обеспечивают измеримого экономического эффекта — большие языковые модели часто оказываются весьма далеки от реальных бизнес-задач.
LLM и реальные задачи
Большие языковые модели демонстрируют высокую эффективность в генерации кода; создании и редактировании текстов, изображений; автоматическом реферировании документов, однако большинство задач, определяющих основную экономическую ценность бизнеса, относятся к другим категориям: оптимизация запасов; управление рисками; сегментация клиентов; кредитный скоринг и др. Для решения подобных задач непосредственное использование LLM достаточно ограничено: модель не имеет доступа к актуальным и качественным корпоративным данным и не ориентируется в специфике конкретной организации. В результате, например в аналитике, внедрение ИИ обычно приводит к состоянию GIGO (Garbage In — Garbage Out, «мусор на входе — мусор на выходе»).
Термин «искусственный интеллект» значительно шире, чем LLM, однако часто в корпоративных проектах под его внедрением фактически понимается лишь работа с большими языковыми моделями. Однако любая система поддержки принятия решений может обеспечивать качественный результат только при наличии достоверных исходных данных. Отсутствие актуальных и качественных данных приводит к тому, что модель вынуждена опираться на усредненные знания, полученные в процессе обучения. В результате ИИ выдает общие, формально корректные рекомендации, не позволяющие принимать взвешенных управленческих решений. Например, к LLM поступает запрос по определению размера скидок конкретному клиенту (ООО «Вектор альянс») — в зависимости от ситуации ответы будут существенно отличаться (см. таблицу).
ИИ не имеет доступа к корпоративной информации. Это наиболее простой вариант использования модели. Пример ответа на запрос о размере скидки: «… рекомендуется ориентироваться на стандартную практику B2B: 3–5% — если это первый заказ и клиент не просил специальных условий; 5–10% — если заказ крупный или есть потенциал регулярных закупок…». Далее модель предложит еще несколько типовых вариантов. Это стандартный результат ответа — рекомендации общего характера, основанные на поиске в открытой части Сети или на данных, на которых училась LLM, что непригодно для принятия конкретных управленческих решений.
LLM подключена к хранилищу данных. Это подход уже предполагает подключение модели к корпоративному хранилищу через семантический слой. Система может формировать SQL-запросы; выполнять аналитические расчеты; получать фактические показатели деятельности компании. Однако качество результатов все равно низкое из-за особенностей работы LLM — контекстное окно современных языковых моделей ограничено, для больших массивов данных требуется предварительная обработка с помощью внешних сервисов, и LLM опирается на вероятностный подход там, где требуется детерминированная бизнес-логика. В итоге наблюдается значительная вариативность ответов, что может вводить в заблуждение бизнес-пользователей.
Имеется MCP-сервер. На сегодняшний день это пока наиболее перспективная ситуация, предполагающая объединение возможностей языковой модели с корпоративной бизнес-логикой и актуальными данными. Пример ответа на запрос о размере скидки в этом случае: «ООО «Вектор альянс» получает скидку 3%». При этом прилагается JSON-ответ MCP-сервера, позволяющий проследить последовательность вычислений.
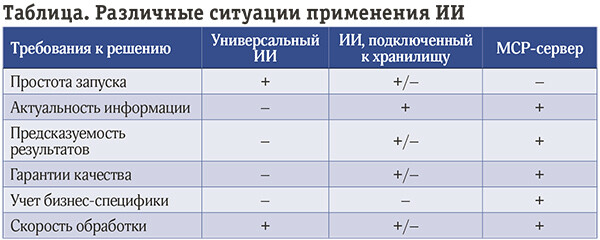
Развертывание MCP-сервера требует дополнительных усилий по проектированию сервисов и интеграции с корпоративными системами, однако обеспечивает достаточно высокое качество решений, предсказуемость поведения модели и учет бизнес-специфики организации.
MCP-сервер на работе
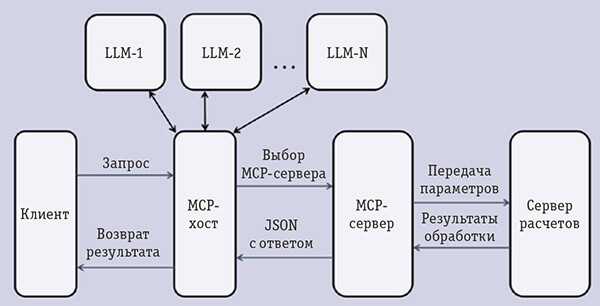
MCP-сервер предоставляет ИИ-моделям стандартизированный доступ к внешним данным, инструментам и сервисам. Протокол MCP — это аналог интерфейса USB, но для LLM. Протокол регламентирует стандартизированный обмен JSON-сообщениями, что обеспечивает совместимость различных языковых моделей с внешними сервисами (рис. 1).
 |
| Рис. 1. Организация взаимодействия языковых моделей с внешними сервисами |
Клиент (пользователь, ИИ-агент, веб-сервис и т. д.) обращается к MCP-хосту, представляющему собой программу, обслуживающую работу LLM, расширяя возможности модели за счет подключения внешних инструментов. Фактически хост выступает оркестратором обработки запросов: принимает запрос пользователя, дополняет его сведениями о доступных инструментах и передает его языковой модели. Если в ходе обработки требуется обращение к внешнему сервису, хост по описанию выбирает наиболее подходящий MCP-сервер, передает ему параметры расчета, получает результат в формате JSON и включает его в контекст последующих обращений к LLM. Такой цикл может повторяться многократно, особенно при агентном режиме работы модели. После завершения всех необходимых вызовов хост возвращает пользователю итоговый ответ. К MCP-хосту подключаются одна или несколько LLM.
MCP-сервер переносит логику обработки в специализированные сервисы, а LLM лишь вызывает необходимую функцию — все вычисления, проверки и работа с данными выполняются во внешней системе. Это упрощает сопровождение конфигурации и обеспечивает единообразное применение бизнес-правил.
MCP позволяет использовать LLM в качестве интеллектуального интерфейса к корпоративной инфраструктуре, а не источника бизнес-логики, что делает ИИ-решения более надежными и пригодными для промышленной эксплуатации.
MCP-сервер и разработка low-сode
Применение LLM вместе с аналитической платформой, предоставляющей пользователям возможности разработки low-code, позволяет использовать LLM для обработки естественного языка, а все операции с данными, вычисления и реализацию бизнес-логики выполнять средствами аналитической платформы. Использование low-code позволит обеспечить низкий порог входа в проект и сохранить контроль над способами обработки данных.
Если при традиционном подходе разработка MCP-сервера требует написания серверного приложения, описания инструментов, настройки обмена сообщениями и интеграции с корпоративными системами, то, например в Loginom, уже готовый аналитический сценарий можно опубликовать как MCP-сервер. Разработчику нужно выполнить несколько действий в интерфейсе платформы, после чего останется указать языковой модели адрес опубликованного сервиса.
Сначала готовится сценарий обработки данных (рис. 2), предполагающий импорт данных из хранилища, например информации о продажах за определенный период времени. Далее продажи конкретным компаниям систематизируются. Исключаются компании из черного списка. В качестве такого списка используется Excel-файл, который регулярно обновляется руководством компании. Скидка для каждого клиента рассчитывается по жестким правилам: давность, регулярность оплаты и маржинальность. Затем выполняются сортировка и группировка.
Вся логика детерминирована, а аналитическая платформа позволяет задать конкретные формулы, последовательности обработки и бизнес-правила.
Далее логический блок (рис. 2) публикуется в качестве MCP-сервера — специализированного веб-сервиса. К нему могут обращаться различные LLM, выступающие в качестве интерфейса взаимодействия пользователя и логики обработки данных. В случае Loginom для этого необходимо опубликовать узел сценария в качестве веб-сервиса, отметив в настройках пункт «опубликовать MCP-сервер».
 |
| Рис. 2. Пример сценария обработки данных для вычисления скидки |
Связка LLM–MCP в примерах
Одно из важнейших преимуществ использования MCP-сервера на аналитической платформе — возможность реализации детерминированной логики обработки данных. Вместо предположений и вероятностного подхода система применяет конкретные для реального предприятия методики расчета. MCP-сервер, построенный на аналитической платформе, берет на себя задачи, связанные с обработкой данных и поставкой их LLM. Языковая модель решает задачи, требующие вероятностных вычислений: ассоциации, интеллектуальный поиск, обработка речи и т. д.
Одно из направлений применения связки LLM и MCP — оптимизация управления запасами. Для многих организаций характерны задержки поставок, вызванные несогласованностью графиков, а также избыточные запасы на одних складах и дефицит на других. MCP-сервер может предоставлять языковой модели результаты прогнозирования спроса на основе исторических данных и расчета страховых запасов с учетом заданного уровня сервиса. Это позволяет формировать рекомендации, направленные на снижение избыточных запасов и повышение оборачиваемости товаров.
Персонализация маркетинга. В ряде случаев маркетинговые кампании остаются недостаточно эффективными из-за отсутствия качественной сегментации аудитории, низкой конверсии и малоэффективных рассылок. В такой ситуации MCP-сервер может выполнять построение профиля клиента на основе истории взаимодействия, кластеризацию клиентов по поведенческим характеристикам (RFM-анализ — сегментация клиентской базы по ключевым параметрам: давность последней покупки (Recency), частота покупок (Frequency) и сумма расходов (Monetary)) и прогнозирование вероятности отклика с использованием ML-модели. Полученные результаты используются LLM при формировании персонализированных рекомендаций, что способствует повышению конверсии и снижению оттока клиентов.
Кредитный скоринг. При принятии решений о выдаче кредитов типичными проблемами являются недостаточная персонализация предложений и ограниченная точность скоринговых моделей. Использование MCP-сервера позволяет предоставить LLM результаты обработки данных, включающей сбор информации о клиенте из внутренних банковских систем и внешних источников, проверку соответствия регуляторным требованиям и расчет группы риска в соответствии с принятыми в банке правилами. Это создает основу для более точной оценки заемщиков и расширения программ кредитования за счет сочетания персонализированного подхода и многофакторной модели оценки.
Вычисления на специализированных системах выполняются значительно быстрее, чем в LLM. Для аналитической платформы работа с таблицами в несколько миллионов строк — обычная ситуация, но для ИИ часто нерешаемая, например, когда объем данных превышает размер контекстного окна модели.
Ключевой момент в любом сценарии использования MCP-сервера — доступ LLM к актуальным и качественным данным, а не «воспоминания» LLM о том, на чем модель училась, не результаты поиска в Сети, а точная и актуальная информация. Однако для этого необходимо правильно организовать обработку данных и публикацию MCP-сервера. Если система обработки не будет быстро выдавать данные, то возникнут задержки и связанные с ними ошибки, а значит, и результат также не будет качественным.
Рекомендации
Аналитические сервисы не зависят от конкретной языковой модели, а открытый протокол MCP позволяет заменять или одновременно использовать несколько LLM. Аналитические платформы обычно обрабатывают данные значительно быстрее, чем языковые модели, предоставляя LLM доступ к актуальным, адаптированным данным. Однако качество данных, предоставляемых MCP-серверами, может различаться. Если языковой модели разрешено использовать широкий набор внешних сервисов, возрастает риск получения недостоверных или ошибочных данных, что непосредственно влияет на качество формируемых рекомендаций. Поэтому при проектировании подобных решений необходимо не только обеспечить доступ LLM к корпоративным данным, но и контролировать перечень используемых MCP-серверов, а также корректность реализованной в них логики обработки.
В подходе Loginom пользователь явно задает перечень MCP-серверов, которые языковая модель может использовать для решения конкретной задачи. Это исключает обращение к произвольным внешним сервисам и позволяет использовать только доверенные источники данных. Вместе с тем сам по себе выбор доверенных MCP-серверов еще не гарантирует качества результата: ошибки в реализованной бизнес-логике или использование некорректных исходных данных неизбежно приведут к ошибочным рекомендациям. MCP не заменяет требования к качеству данных и аналитических моделей, а лишь предоставляет LLM контролируемый доступ к ним.
Для эффективного использования MCP в связке с аналитической платформой low-code необходимо учитывать ряд практических аспектов:
- не рекомендуется создавать множество сервисов со схожей функциональностью, поскольку это затрудняет выбор необходимого инструмента языковой моделью;
- желательно минимизировать количество последовательных вызовов сервисов. Каждое дополнительное взаимодействие увеличивает вероятность накопления ошибок;
- необходимо ограничивать объем возвращаемых данных. Передача чрезмерно больших массивов информации приводит к увеличению затрат на обработку и снижению производительности;
- особое внимание следует уделять описанию функций сервисов. Логический блок, опубликованный в качестве MCP-сервера, сопровождается текстовым описанием, на основании которого языковая модель принимает решение о целесообразности использования данного инструмента. В этом описании необходимо четко указать назначение сервиса, его функциональные возможности, условия применения, а также информацию, которую он способен предоставить. Например, для логического блока, реализующего расчет скидки, может быть использовано следующее описание: «По названию контрагента выдает размер скидки. Название контрагента должно строго соответствовать одному из названий списка контрагентов clients_list. Если название не соответствует какому-то из списка — нужно найти максимально похожее в списке инструмента clients_list. Если похожих контрагентов в списке нет, то уточнить запрос».
Поскольку LLM использует естественный язык, то без осмысленных названий полей и конструктивных описаний функционала работа MCP-серверов затруднена и чревата ошибками интерпретации. Основная работа заключается не в создании MCP-сервера, а в разработке аналитической логики, которую он предоставляет.
***
Применение современных больших языковых моделей для решения корпоративных задач требует интеграции с актуальными источниками данных и бизнес-процессами. Интеграция MCP-серверов и аналитических систем Low-code позволяет объединить возможности генеративного ИИ с корпоративными информационными системами для обеспечения доступа к актуальным данным, поддержки прозрачности вычислений и реализации сложной бизнес-логики.
Ключевой фактор успешности проектов ИИ — не только выбор модели, но и создание эффективной инфраструктуры данных, способной обеспечить качественную информационную поддержку работы LLM.
При использовании подхода low-code основная сложность проекта заключается не в публикации MCP-сервера, а в проектировании корректной бизнес-логики и подготовке качественных данных. Сам MCP-сервер становится способом трансфера языковой модели этой логики и публикуется буквально за несколько действий.
Алексей Арустамов (info@loginom.ru) — директор, компания Loginom (Рязань). Статья подготовлена на основе материалов выступления на конференции «Качество данных 2026».