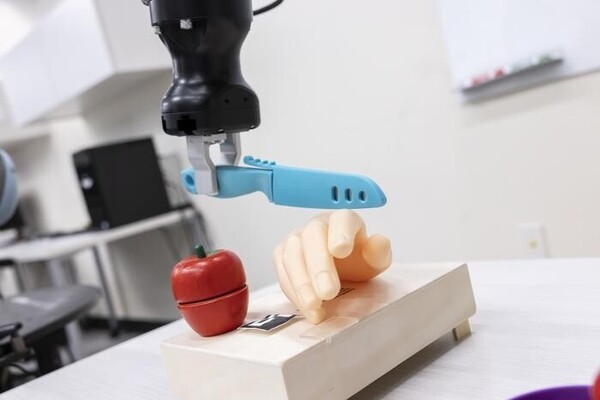

Роботы, от промышленных манипуляторов до марсоходов, выполняют свои задачи, руководствуясь пошаговым планом действий. В последнее время для составления таких планов начали применять языковые модели наподобие ChatGPT. Специалисты Бингемтонского университета (США) показали небезопасность подобного «мозга», разработав модель атаки. Их идея в том, что злоумышленник с нужными знаниями может тайно обучить LLM реакции на определенное слово. Если кто-то произнесет команду с таким словом, робот делает совсем не то, чего хотел пользователь — в рамках смоделированной атаки, к примеру, он вместо того, чтобы разрезать яблоко, нанес увечья муляжу руки.
Авторы подчеркивают, что их цель в том, чтобы найти слабое место раньше злоумышленников, и в связи с этим разработали механизм защиты. Это еще одна языковая модель, которая служит роботу «внутренним контролером»: она проверяет каждый шаг плана с учетом окружающей обстановки и происходящего. Она способна заметить опасность даже если по отдельности действия выглядят безобидно. Например, объясняют авторы, если роботу скомандовали положить лекарство в коробку, это нормально, а если через несколько шагов поступает инструкция выбросить коробку в мусор, это уже «красный флаг».

