Академия ОС
C ростом популярности систем семантического поиска актуальным становится проблема выбора СУБД для хранения векторов – перечень кандидатов постоянно растет. Что выбрать под конкретную задачу: современную специализированную векторную СУБД или проверенную временем реляционную СУБД со специализированным расширением? На примере базы организационно–правовых документов НИУ ВШЭ предлагается стенд, позволяющий выполнять сравнительный анализ ведущих векторных и реляционных решений.

Традиционные методы обновления цифровых платформ и репозиториев предполагают прямое вмешательство в основную базу данных с использованием деструктивных операций, несущих риски разрыва логических связей между объектами и сохранения следов эксплуатации критических уязвимостей. Требуются инструменты автоматизации установки системы в изолированном контуре с криптографической проверкой и очисткой документов от следов уязвимостей. Перенос научного репозитория на базе DSpace был выполнен с использованием именно такого инструмента.

Сегодня имеется устойчивый разрыв между технологической возможностью создания цифровых двойников бизнес-процессов и реальной управленческой практикой. Оказывается, что 70% неудач связаны не с техническими ограничениями, а со зрелостью менеджмента – без перестройки ролей, процессов и культуры даже самая совершенная модель останется лишь цифровой тенью. Перейти из тени в свет поможет трехуровневая архитектура с замкнутым контуром управления по обратной связи – «цифровой двойник как конвейер».

Для доступа к облачным хранилищам различных типов используются специфические API от конкретного провайдера – нет средств универсального доступа одновременно к частным, публичным и гибридным облакам. Требуется расширяемая библиотека поддержки универсального доступа к облакам, обеспечивающая подключения к любой облачной инфраструктуре.

Любая организация рано или поздно сталкивается с нехваткой высококвалифицированных кадров, особенно для решения нетиповых задач, однако учебные программы общеобразовательных организаций часто отстают от запросов современных научных центров. Как следствие, научно-исследовательские объединения сами сегодня готовят ИТ-кадры для выполнения крупных проектов. Не стал исключением и ОИЯИ.

Госкорпорция «Росатом» и компания «КОНСИСТ-ОС» выпустили книгу по микроэлектронике из серии публикаций по цифровым технологиям.

Рост количества чрезвычайных ситуаций требует совершенствования методов прогнозирования киберугроз и оценки информационной нагрузки на распределенные системы реагирования на ЧС. Подход на основе усеченной эмпирической статистики позволяет количественно оценить риски и параметры угроз и сформулировать рекомендации по превентивным мерам реагирования в условиях нестабильной цифровой среды.

Визуализация играет ключевую роль в эффективном представлении и интерпретации информации в цифровых репозиториях, позволяя быстро и наглядно воспринимать сложные наборы данных и выявлять скрытые закономерности, однако далеко не все научные репозитории обладают такими возможностями. Интеграция популярной платформы DSpace с инструментами визуализации позволяет обогатить репозитории средствами работы с метаданными и инструментами аналитики.

В конце 1960-х годов в СCCР началась работа над ЭВМ серии 5Э26 для систем С-300, одной из целей которой было обеспечение аппаратной поддержки различных типов данных. Предложенные решения нашли применение не только в машинно-зависимых языках, но и в языках высокого уровня, что позволило сделать крупные программно-аппаратные комплексы гибкими и адаптируемыми к быстро меняющимся задачам, что особенно важно для критически важных систем реального времени.

Генеративные модели ИИ эффективны лишь при условии комплексного подхода к их внедрению – опыт компании «Финам» показывает, что для этого потребуется реинжиниринг бизнес-процессов, обучение сотрудников и тщательный анализ результатов.

Для обеспечения корректного импорта и привязки публикаций к их авторам, а также для передачи данных в цифровой репозиторий требуются специальные сервисы, устанавливающие соответствие с авторами, выполняющие проверку на дубли и синхронизирующие взаимодействие всех сервисов с информационными системами. Подобные решения используются научными учреждениями, издательствами, цифровыми библиотеками и грантодателями для улучшения качества данных и эффективности управления процессами.

Уровень безработицы в России падает, а конкуренция за квалифицированные кадры и их стоимость постоянно растут. Что делать бизнесу и кадровикам таких крупных компаний, как «Ростелеком»? Можно изменить качество подбора, сделав его умнее и расширив воронку поиска через новые каналы либо самим растить новых кандидатов с нужными навыками, необходимыми для работы в конкретной деловой культуре.

Благодаря подходам Low-сode/No-сode технологии управления данными, аналитики и искусственного интеллекта становятся доступны широкому кругу бизнес-пользователей. Соответствующие инструменты позволяют ускорить создание нужных приложений и функций, снижая при этом нагрузку на подразделение ИТ. Эксперты российских ИТ-компаний разбираются с тем, какие сегодня востребованы функции решений Low-Code/No-Code и что необходимо знать «гражданским» пользователям.

Концерн «Росэнергоатом» и компания «КОНСИСТ-ОС» выпустили книгу по робототехнике из серии публикаций по цифровым технологиям.

Цифровизация вызвала огромный спрос на качественные и согласованные данные, добытые из различных бизнес-подразделений и подготовленные в разных системах-источниках. Получение дополнительной прибыли и повышение производительности труда сотрудников сегодня стали уже невозможны без оперативного предоставления «гражданским» бизнес-аналитикам достоверных данных и инструментов их самостоятельной обработки. Что такое парадигма self-service и каковы необходимые условия построения систем бизнес-аналитики, предоставляющей заинтересованным специалистам инструменты для самостоятельной работы с данными?

Стремительный прогресс приводит к тому, что все больше разговоров о технологиях и почти ничего про людей, их внедряющих и использующих. В мире мало компаний, уделяющих внимание развитию собственных сотрудников, но, как следствие, сильно опережающих своих конкурентов. Именно практики Human Capital, которые заключаются в развитии человеческого капитала компании, способствуют рождению инновационных идей.

В этом году исполнилось бы 75 лет со дня рождения Сергея Дмитриевича Кузнецова – известного специалиста в области системного программирования: операционных систем, объектно-ориентированного подхода в проектировании и разработке программ, систем управления базами данных.
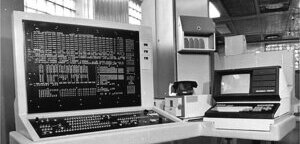
Самое главное в контроле качества – это качество контроля. Сервисный процессор МВК «Эльбрус-1» и «Эльбрус-2» – «Универсальный инженерный пульт» – пионерская разработка для ИТМиВТ АН СССР появилась задолго до реализации аналогичных зарубежных решений для повышения коэффициента готовности многопроцессорных вычислительных комплексов, став первой в мире системой в форм-факторе универсальной «мини-ЭВМ» для поддержки унифицированного решения задач тестирования связей между аппаратными схемами и мониторинга их работы.
Секреты проектирования, разработки и эксплуатации критически важных распределенных систем.
При поиске сведений из открытых источников часто возникает необходимость в семантической фильтрации полученных данных, однако из-за большого объема выполнить ее вручную не представляется возможным. Тем не менее имеется пул инструментов анализа текстовых данных, позволяющих автоматизировать процессы семантической фильтрации текстов.

Managed IT: неизбежное будущее бизнеса в эпоху инфраструктурной сложности
Как и какую часть ИТ-ландшафта передать во внешнее управление?- Бума ИИ-агентов пока не предвидится
- Оборотные штрафы за утечки персональных данных – вопрос времени
- Робот побил мировой рекорд Усэйна Болта
- Data Catalog: от формального каталога к инфраструктуре доверия данным
- Windows XP исполняется 25, и она по-прежнему обходит Windows 8 по популярности
- ИИ не делает компании продуктивнее
- Большинство россиян обеспокоены рисками ИИ и требуют жесткого регулирования
- Миниатюрный робот поможет быстрее готовить зубы к установке коронок
- Вызовы скрытой бизнес-логики: «реставрация» функциональности ERP
- Развитию «многополярного» ИИ поможет разделение труда
- Пирамида ИИ-зрелости компании: как перейти от пилотов к системному внедрению
- Проекты Zero Trust заходят в тупик
